2026 맥 스튜디오(Mac Studio) M5 Max·M5 Ultra 사양과 가격 정리
2026년 8월 발표된 맥 스튜디오(Mac Studio) M5 Max·M5 Ultra의 사양과 국내 가격·출시일, Qwen 로컬 LLM 실측 성능, NVIDIA DGX Spark와의 장단점 비교를 정리합니다.
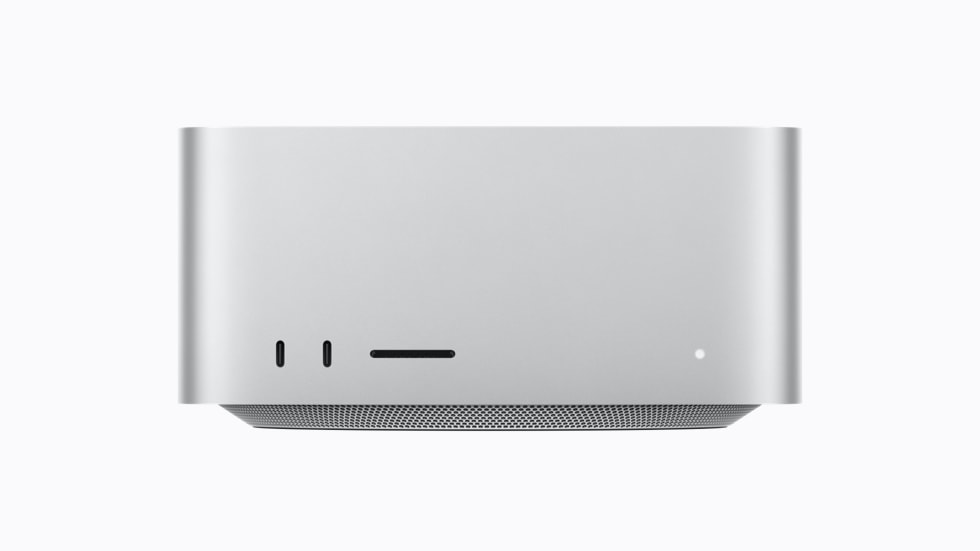
Apple이 2026년 8월 25일 M5 Max와 M5 Ultra 칩을 탑재한 새 맥 스튜디오(Mac Studio)를 발표했습니다. 2025년 M4 Max·M3 Ultra 모델 이후 1년 반 만의 업데이트인데, Apple은 이번 모델을 "지금까지 가장 강력한 Mac"이라고 소개했습니다1. 외형은 그대로이고 칩과 연결성이 바뀐 사양 업데이트라서, 무엇이 달라졌는지 위주로 Apple 공식 발표 기준으로 정리해 봤습니다.
2026 맥 스튜디오 핵심 사양
M5 Max와 M5 Ultra 칩
이번 맥 스튜디오는 두 가지 칩 중에서 고를 수 있습니다. M5 Ultra는 처음으로 GPU 코어마다 Neural Accelerator를 넣은 Ultra 칩입니다1.
| 항목 | M5 Max | M5 Ultra |
|---|---|---|
| CPU | 18코어 (슈퍼 코어 6 + 성능 코어 12) | 최대 36코어 (슈퍼 코어 12 + 성능 코어 24) |
| GPU | 최대 40코어 | 최대 80코어 |
| 통합 메모리 | 최대 128GB | 최대 512GB |
| 메모리 대역폭 | 최대 614GB/s | 1.2TB/s |
| 미디어 엔진 | H.264, HEVC, ProRes, AV1 디코딩 | M5 Max의 2배 인코딩·디코딩 블록 |
M5 Ultra의 메모리 대역폭은 이전 세대(M3 Ultra)보다 50% 늘었습니다. 최대 512GB 통합 메모리는 큰 LLM을 로컬에서 돌리려는 사람에게 가장 눈에 띄는 부분일 것 같습니다. 다만 512GB 모델은 다른 모델보다 늦은 10월 말에 출시됩니다1.
저장장치와 연결성
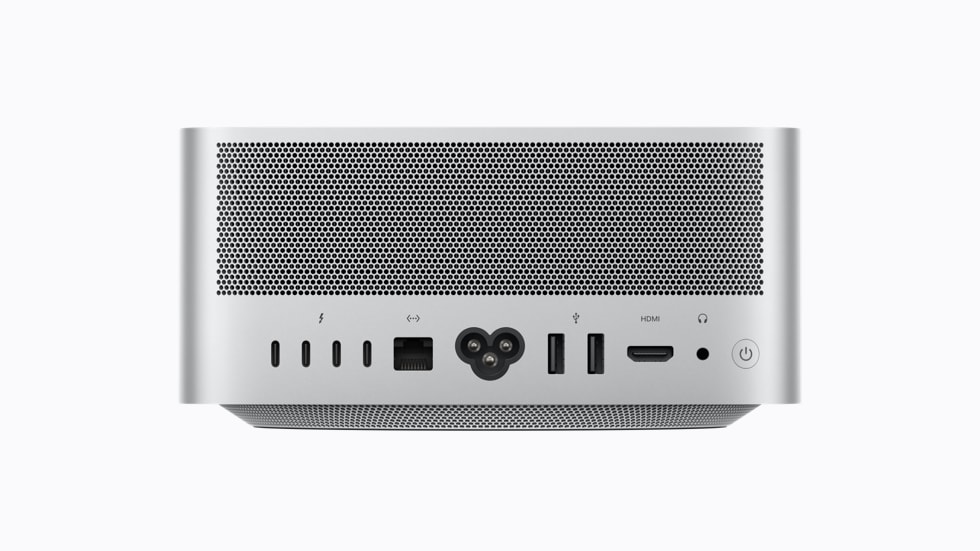
- SSD: 새 SSD 구조로 이전 세대보다 최대 2배 빠릅니다.
- Thunderbolt 5: 최대 6개, 포트당 최대 120Gb/s
- 디스플레이: 최대 8대, 또는 5K 120Hz Studio Display XDR 최대 4대
- 무선: Apple이 설계한 N1 칩으로 Wi-Fi 7과 Bluetooth 6 지원(맥 스튜디오에서는 처음)
- USB-C 젠록(genlock): iPhone 17 Pro 같은 프로용 카메라와 영상 동기화
- 클러스터링: 여러 대의 맥 스튜디오를 Thunderbolt 5와 RDMA로 묶어 AI 추론을 나눠 처리할 수 있습니다.
Apple이 발표한 성능 수치
아래 수치는 모두 Apple이 2026년 7월 자체 테스트한 결과입니다1. 실제 체감 성능은 작업과 구성에 따라 다르니 참고용으로 보는 게 좋습니다.
M5 Max (M4 Max 대비)
- LM Studio LLM 프롬프트 처리 최대 3.9배
- 텍스트-이미지 생성 최대 3.5배
- DaVinci Resolve Studio Magic Mask 최대 3배
- GPU 성능 최대 50% 향상
M5 Ultra (M3 Ultra 대비)
- AI 최대 연산 성능 최대 4.3배
- LM Studio 프롬프트 처리 최대 4배
- Foundry Nuke CopyCat 머신러닝 학습 최대 3.3배
- 멀티스레드 CPU 성능 최대 1.3배, 그래픽 최대 1.8배
- 8K ProRes 422(30fps) 스트림 최대 33개 동시 재생
전체적으로 CPU 향상 폭(1.3배)보다 AI·GPU 쪽 향상 폭이 훨씬 큽니다. GPU 코어마다 들어간 Neural Accelerator 덕분인데, 로컬 LLM이나 이미지 생성처럼 GPU를 많이 쓰는 작업이라면 체감 차이가 클 것 같습니다.
실제 로컬 LLM 성능 (Qwen·DeepSeek)
위 수치는 Apple 자체 테스트라서, 출시 후 나온 리뷰의 실측치를 따로 찾아봤습니다. 로컬 LLM의 토큰 생성 속도는 칩 성능보다 메모리 대역폭에 크게 좌우되기 때문에, 대역폭이 1.2TB/s인 M5 Ultra가 유리한 분야입니다.
Qwen 3.8 27B (dense 모델)
Tom's Hardware는 메모리 대역폭을 많이 쓰는 dense 모델인 Qwen 3.8 27B(Q4_K_M)를 llama.cpp로 돌려 M4 Max, NVIDIA DGX Spark와 비교했습니다2. 컨텍스트 길이별 생성 속도(토큰/초)는 다음과 같습니다3.
| 컨텍스트 | M5 Ultra | M4 Max | DGX Spark |
|---|---|---|---|
| 0 | 46.3 | 22.7 | 11.8 |
| 16K | 43.4 | 21.1 | 11.0 |
| 64K | 32.4 | 14.6 | 9.3 |
| 128K | 30.1 | 9.0 | 7.7 |
M5 Ultra가 M4 Max의 약 2배, DGX Spark의 약 4배 속도입니다. 다만 첫 토큰이 나오기까지의 시간(TTFT)은 32K까지만 M5 Ultra가 빠르고, 128K에서는 DGX Spark가 더 빨랐습니다(295.8초 대 236.8초)3.
LM Studio에서 4비트 MLX 버전으로 측정한 BGR 리뷰에서는 같은 모델이 M5 Ultra에서 초당 약 55토큰, 이전 세대 M3 Ultra에서 약 40토큰이었습니다. M5 Max(MacBook Pro)는 M3 Ultra와 비슷한 수준이었다고 합니다4.
Qwen MoE 모델
MoE(전문가 혼합) 모델은 전체 크기는 커도 토큰마다 일부 파라미터만 쓰기 때문에 dense 모델보다 빠릅니다.
- Qwen 3.5 122B A10B: M5 Ultra 초당 약 80토큰, M3 Ultra 약 60토큰(LM Studio)4
- Qwen3.8-Flash-Next: M5 Ultra(256GB)에서 MLX로 4K 컨텍스트 초당 90.7토큰, 128K에서도 60.6토큰. 16K 프롬프트 처리 속도는 초당 2,887토큰으로 M3 Ultra(1,143토큰)의 약 2.5배입니다(MacStories 측정)3.
DeepSeek
M5 Ultra에서 DeepSeek 대형 모델을 실측한 공개 자료는 아직 찾지 못했습니다. 메모리 대역폭으로 계산한 추정치만 돌고 있어서 여기에는 옮기지 않았습니다. DeepSeek V3·R1(671B) 같은 대형 모델은 4비트로 줄여도 수백 GB가 필요해서, 사실상 10월 말 나오는 512GB 모델이 출시된 뒤에야 제대로 된 측정 결과가 나올 것 같습니다.
NVIDIA DGX Spark와 비교
로컬 AI용 데스크톱으로 맥 스튜디오와 가장 많이 비교되는 제품이 NVIDIA DGX Spark입니다. GB10 Grace Blackwell 칩에 128GB 통합 메모리를 넣은 손바닥만 한 AI 전용 컴퓨터입니다5.
| 항목 | Mac Studio (M5 Max) | Mac Studio (M5 Ultra) | DGX Spark |
|---|---|---|---|
| 칩 | M5 Max | M5 Ultra | GB10 Grace Blackwell |
| 메모리 | 최대 128GB | 최대 512GB | 128GB LPDDR5x |
| 메모리 대역폭 | 614GB/s | 1.2TB/s | 273GB/s |
| 운영체제 | macOS | macOS | DGX OS (Linux) |
| 여러 대 연결 | Thunderbolt 5 + RDMA | Thunderbolt 5 + RDMA | ConnectX-7 200Gbps, 최대 4대 |
맥 스튜디오의 장점
- 생성 속도: 대역폭이 DGX Spark의 2.2배(M5 Max)~4.4배(M5 Ultra)라서, 혼자 쓰는 채팅·에이전트 작업의 토큰 생성이 훨씬 빠릅니다.
- 메모리 용량: M5 Ultra는 최대 512GB까지 넣을 수 있어 한 대로 더 큰 모델을 올릴 수 있습니다. DGX Spark는 128GB가 상한이라 더 큰 모델은 여러 대를 연결해야 합니다.
- 범용성: 영상 편집, 개발 같은 일반 작업용 Mac으로도 그대로 쓰고, LM Studio·Ollama·MLX로 바로 로컬 LLM을 돌릴 수 있습니다.
맥 스튜디오의 단점
- CUDA 미지원: vLLM, SGLang처럼 클라우드 GPU에서 쓰는 스택이나 파인튜닝 생태계는 NVIDIA 쪽이 훨씬 넓습니다.
- 긴 프롬프트 처리: 위 테스트처럼 128K 같은 아주 긴 컨텍스트에서는 첫 토큰까지 DGX Spark보다 느렸고, 프롬프트 처리 속도는 RTX 5090의 절반 정도입니다(6K 프롬프트 기준 초당 1,701토큰 대 3,031토큰)3.
- 가격: M5 Ultra는 시작가부터 DGX Spark보다 훨씬 비쌉니다.
DGX Spark가 더 맞는 경우
- CUDA 기반으로 모델을 개발·파인튜닝하거나, 클라우드에 배포할 코드를 같은 환경에서 미리 돌려보고 싶을 때. NVIDIA는 한 대로 최대 200B 모델 추론, 70B 모델 파인튜닝이 가능하다고 밝혔습니다5.
- 여러 요청을 동시에 처리할 때. LMSYS 측정에서 Llama 3.1 8B는 요청 1개일 때 초당 20.5토큰이었지만 32개를 묶어 처리하면 초당 368토큰까지 올라갔습니다6.
반대로 같은 측정에서 Llama 3.1 70B는 초당 2.7토큰에 그쳐서, 큰 모델을 혼자 빠르게 쓰는 용도로는 대역폭 한계가 뚜렷합니다6. 정리하면 혼자 큰 모델을 빠르게 쓰려면 맥 스튜디오, CUDA 개발이나 동시 처리 중심이면 DGX Spark가 맞습니다.
국내 가격과 출시일
Apple 발표 당시 국내 시작 가격은 다음과 같습니다7. 실제 판매 가격은 구성(메모리·SSD)과 판매처, 시기에 따라 달라집니다.
| 모델 | 시작 가격 | 교육용 |
|---|---|---|
| M5 Max | 4,290,000원부터 | 3,949,000원부터 |
| M5 Ultra | 9,490,000원부터 | 8,799,000원부터 |
- 국내 사전 주문: 2026년 8월 27일 오전 10시부터
- 배송·매장 판매: 9월 22일부터
- 512GB 통합 메모리 모델: 10월 말 출시
어떤 모델이 맞을까
Apple 발표 사양을 기준으로 보면 선택 기준은 비교적 단순합니다.
- M5 Max: 영상 편집, 3D 작업, 개발용으로 충분한 성능에 가격이 절반 이하입니다. 메모리가 128GB면 충분한 작업이라면 이쪽이 합리적입니다.
- M5 Ultra: 128GB를 넘는 메모리가 필요하거나(대형 LLM 로컬 실행 등), 8K 다중 스트림·대규모 렌더링처럼 GPU와 미디어 엔진을 한계까지 쓰는 작업에 맞습니다.
macOS 27도 올가을 무료 업데이트로 나올 예정이라, 새 맥 스튜디오에서 Apple Intelligence와 새 Siri 기능도 함께 쓸 수 있게 됩니다1.
더 자세한 정보는 아래 링크를 확인하세요.

참조
Footnotes
-
https://www.apple.com/newsroom/2026/08/apple-introduces-new-mac-studio-with-m5-max-and-m5-ultra/ ↩ ↩2 ↩3 ↩4 ↩5
-
https://www.tomshardware.com/desktops/mini-pcs/apple-mac-studio-m5-ultra-review ↩
-
https://www.contextstudios.ai/blog/mac-studio-m5-ultra-local-ai-guide ↩ ↩2 ↩3 ↩4
-
https://www.bgr.com/2264114/mac-studio-m5-ultra-review/ ↩ ↩2
-
https://www.nvidia.com/en-us/products/workstations/dgx-spark/ ↩ ↩2
-
https://www.apple.com/kr/newsroom/2026/08/apple-introduces-new-mac-studio-with-m5-max-and-m5-ultra/ ↩