DeepLでページ全体を翻訳するときにcodeタグを除外する方法
DeepLのChrome拡張機能でページ全体を翻訳すると、codeタグまで翻訳されて改行が崩れてしまいます。 Tampermonkeyを使えばtranslate="no"属性を追加して、ページ翻訳時に除外される部分を作ることができます。 以下でその方法を説明します。
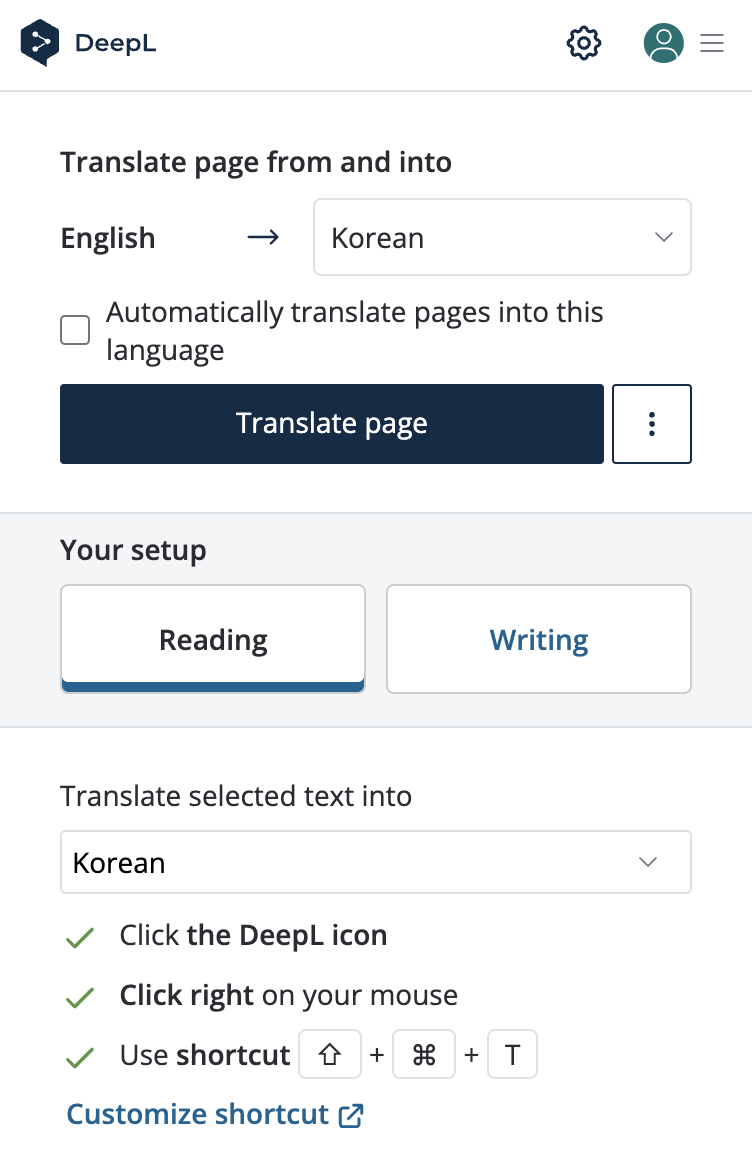
DeepL Chrome拡張機能を使うときの問題
DeepLが韓国での決済に対応したことで、これまで選択した部分だけを少しずつ 翻訳して読んでいたのが、Webページを一度にまとめて翻訳して読めるようになりました。
ところが使い続けているうちに、コードを含むドキュメントに出会うと、わざわざコード部分まで翻訳してコードのフォーマットが崩れる現象が起きました。 (フォーマットが崩れるときもあれば、崩れないときもあります。)
この問題を解決するためにcodeタグを翻訳させない方法を探したところ、Google翻訳の場合、
翻訳したくないHTMLタグにtranslate="no"属性を追加するか、class属性にnotranslateを追加すると、
その要素は翻訳されずにスキップされるという記事を見つけました。 1
DeepLでも対応しているか疑問でしたが、調べてみるとtranslateはW3C標準に含まれている内容なので、対応していそうでした。 2
Tampermonkeyで解決
Chrome拡張機能を自分で作ってインストールしないといけないのか…そこまではしたくないなと思っていたところ、検索していて同じ悩みを 抱えていた方が解決した記事を見つけました。(日本語の記事です。) 3
Tampermonkeyは、ブラウザで開くページにJavaScriptを差し込んで実行してくれる拡張機能です。 Chrome拡張機能を作らなくても、簡単なスクリプトを開くすべてのページ(または指定したサイトやページ)で実行 させることができます。
Tampermonkeyのインストールと設定
Chromeウェブストアからインストールします:https://chrome.google.com/webstore/detail/tampermonkey/dhdgffkkebhmkfjojejmpbldmpobfkfo
インストール後に「新規スクリプトを作成...」を実行すると、コードを編集する画面が開きます。下のコードのように修正します。
@matchの部分は、すべてのページで実行されるように必ず変更してください。
// ==UserScript==
// @name         Codetag notranslate
// @namespace    http://tampermonkey.net/
// @version      0.1
// @description  add notranslate class to code related tags
// @author       You
// @match        *://*/*
// @icon         https://www.google.com/s2/favicons?sz=64&domain=tampermonkey.net
// @grant        none
// ==/UserScript==

(function() {
    'use strict';

    // Your code here...
    var codeTags = document.getElementsByTagName('code');
    for (const code of codeTags) {
        code.classList.add('notranslate');
        code.setAttribute("translate","no");
    }
    var preTags = document.getElementsByTagName('pre');
    for (const pre of preTags) {
        pre.classList.add('notranslate');
        pre.setAttribute("translate","no");
    }
    console.log('[CODE] notranslate');
})();
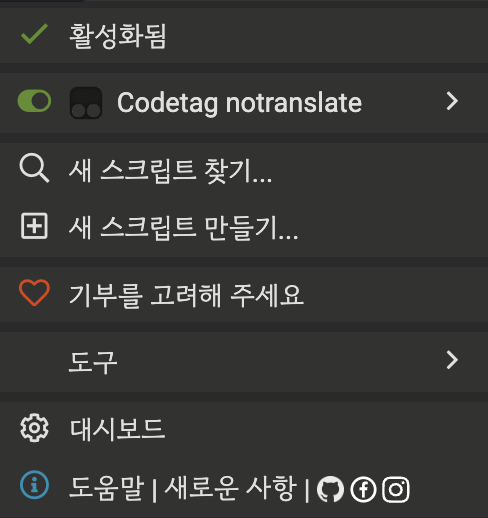
保存すると、上の@nameフィールドに入力した名前でメニューが1つ追加されているはずです。有効にして、
ほかのページでページ全体を翻訳してみると、コード部分を除いて翻訳されるのが確認できます。
使ってみた感想
最初はcodeタグにだけ属性を追加して使おうとしたのですが、属性を無視して翻訳されることがよくあったので、
念のためpreタグにも追加したところ、ほぼコード部分を除いて翻訳されることが確認できました。